OpenSearch 2.19.7
OpenSearch est un moteur distribué de recherche et d'analyse de données textuelles et de journaux. La version 2.19.7 apporte des correctifs de sécurité et de robustesse limitant les dépassements de pile et les saturations mémoire.
Sources officielles uniquement : elles établissent ce que le projet annonce, pas une confirmation indépendante. Aucun benchmark et aucun test local ; les conséquences restent conditionnelles.
OpenSearch est un moteur distribué de recherche et d'analyse de données textuelles et de journaux. La version 2.19.7 apporte des correctifs de sécurité et de robustesse limitant les dépassements de pile et les saturations mémoire.
OpenSearch centralise et interroge des données et des journaux distribués. Sa branche 2.x reçoit ici une mise à jour corrective publiée le 20 octobre 2026 à 22:16:56 UTC (21 octobre à Paris). Les archives mentionnent aussi la version majeure 3.9.0 ; ce dossier ne compare pas leurs performances.
Comprendre la solution
OpenSearch est un moteur distribué de recherche et d’analyse, notamment utilisable pour les données de sécurité. Il stocke des documents JSON dans des index ; ce n’est ni un pare-feu ni un agent de collecte.
Fonctionnement
Chaque index est réparti en partitions (shards). Les répliques fournissent des copies sur d’autres nœuds. Lors d’une écriture, le translog est synchronisé sur disque avant acquittement ; le refresh rend les données interrogeables, tandis que le flush synchronise les segments Lucene et permet de purger les écritures correspondantes du translog. Un index inversé relie les termes aux documents ; BM25 calcule leur pertinence.
Prérequis et déploiement
La distribution Linux inclut un JDK Adoptium compatible. Pour une charge de production, régler vm.max_map_count à au moins 262144 sur l’hôte, y compris avec Docker ; nofile 65536 concerne les fichiers ouverts par l’utilisateur OpenSearch. La documentation recommande des SSD locaux et déconseille le stockage des nœuds sur un système de fichiers réseau. Le verrouillage bootstrap.memory_lock=true s’accompagne de memlock pour désactiver le swapping. Il faut réserver assez de mémoire native en plus du tas Java : les réservations de métadonnées peuvent provoquer un manque de mémoire sur une petite VM. Le dimensionnement dépend donc des données et de la charge.
Intérêt pour le SOC
L’API REST utilise le port 9200 ; la communication interne et la recherche inter-clusters utilisent le port 9300. Le module Security prend en charge TLS sur les couches REST et transport, sous réserve de configuration : cela ne prouve pas le chiffrement de toute la chaîne de collecte. Security Analytics s’installe automatiquement avec les distributions OpenSearch selon la documentation fournie. Ses détecteurs exploitent les journaux et les règles de détection, dont Sigma ; les alertes et notifications nécessitent leur configuration.
Exemple non exécuté
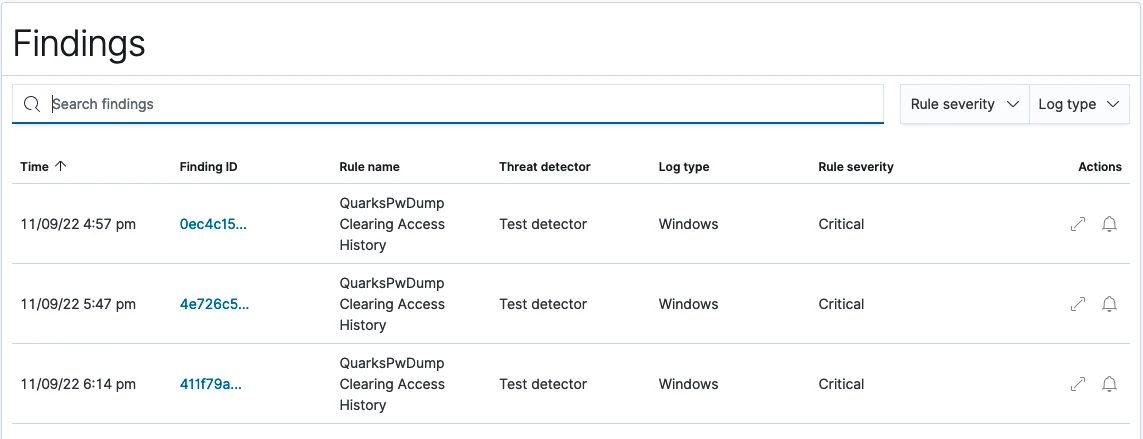
Scénario non exécuté : une équipe ingère des journaux, configure les détecteurs et examine leurs findings (constatations). Un analyste peut ensuite interroger les index. Les correctifs ci-dessous encadrent des entrées précises ; ils ne prouvent pas une disponibilité générale du cluster ni un gain sous charge.
Ce qui change
Le paramètre search.query.max_query_nesting_depth limite précisément la profondeur d’imbrication des parenthèses de query_string, pour prévenir StackOverflowError ; il ne limite pas indistinctement tous les filtres.
Le référentiel de snapshots sur système de fichiers valide base_path afin d’empêcher une traversée hors des répertoires configurés dans path.repo.
Le réglage de cluster monitor.jvm.hot_threads.max_snapshots fixe une borne supérieure au paramètre snapshots du diagnostic hot_threads.
La validation de scroll_id est renforcée contre des identifiants fabriqués contenant des compteurs excessifs susceptibles de provoquer un épuisement mémoire (OOM).
À retenir
L’intérêt SOC est de mieux encadrer certaines requêtes, opérations de diagnostic et configurations de snapshots sur la branche 2.x. Les notes officielles décrivent les changements ; elles ne prouvent pas leur efficacité dans une infrastructure donnée. La traversée de chemins est un problème distinct des causes d’épuisement mémoire.
Intérêt et conditions
- Ces garde-fous visent à prévenir les erreurs de pile ou de mémoire décrites dans les notes. Pour les parenthèses de query_string ou les scroll_id fabriqués concernés.
- La validation réduit le risque de sortir des répertoires autorisés. Pour un référentiel de snapshots de type système de fichiers.
Limites
- La profondeur autorisée et le plafond de diagnostic sont à prendre en compte lors de la qualification. Pour des query_string très imbriquées ou un diagnostic hot_threads.
Termes utiles
- Document
- Unité élémentaire d'information structurée ou textuelle, stockée sous forme d'objet JSON dans OpenSearch.
- Index
- Regroupement logique de documents interrogeables conjointement lors des opérations de recherche.
- Cluster
- Ensemble distribué de nœuds matériels ou virtuels assurant le stockage et le traitement des requêtes.
- Shard
- Partition autonome d'un index constituant une instance Lucene complète pour distribuer la charge.
- Inverted index
- Structure de données associant chaque mot aux documents correspondants afin d'accélérer les recherches.
- Security Analytics
- Solution de gestion des informations et des événements de sécurité intégrée analysant les menaces.